DeepSeek Harness 如何让 Agent 在运行中给自己换插件?——88页Cordis论文解读
DeepSeek Harness 推出的同时,它的底层基座 Cordis 相应的 paper:《A Programming Paradigm for Spatiotemporal Composability》也受到了广泛关注。
但这篇 paper 足足有 88 页,再加上为了建立理论基础而出现的大篇幅数学公式,确实让人望而却步。
所以,这篇文章就带大家解读一下这篇 paper。更多的是基于工程视角,不谈纯理论,主要说清楚三个问题:作者为什么要做 Cordis?Cordis 适合什么类型的系统?它又是怎么实现组件的动态装卸与依赖管理的?
写这篇文章的初衷,是我看了官网的文档,包括插件开发、Cordis 入门等等。
虽然跟着教程也能写出一个插件跑起来,但是却不知道为什么这样做,对于想基于 DeepSeek Harness 做点东西的我来说,还是不够的。
所以,我就去看看 Cordis,并整理出这篇文章。
本文章适合以下人群:
- 想要开发 Agent,或者正在研究 Agent Harness 的开发者;
- 想了解 DeepSeek Harness 底层设计的人;
- 对插件系统、动态加载、热更新和组件依赖管理感兴趣的人;
- 看过 Cordis 或 DeepSeek Harness 的文档,但仍然不理解为什么要这样设计的人。
本文的目标不是讲完论文里的所有理论,而是快速过一遍 Cordis 的核心概念。带着这些概念再去深入 DSH,理解起来会容易很多。
开始时,先设想以下场景,并带着问题开始:
Agent 执行任务时发现自己缺一种能力,于是生成插件 V1 版本,在运行时把它装进 Harness。
使用后发现有问题,它又生成 V2 版本,准备动态替换。
那么怎么在运行时实现优雅替换呢?
从静态组合到动态组合
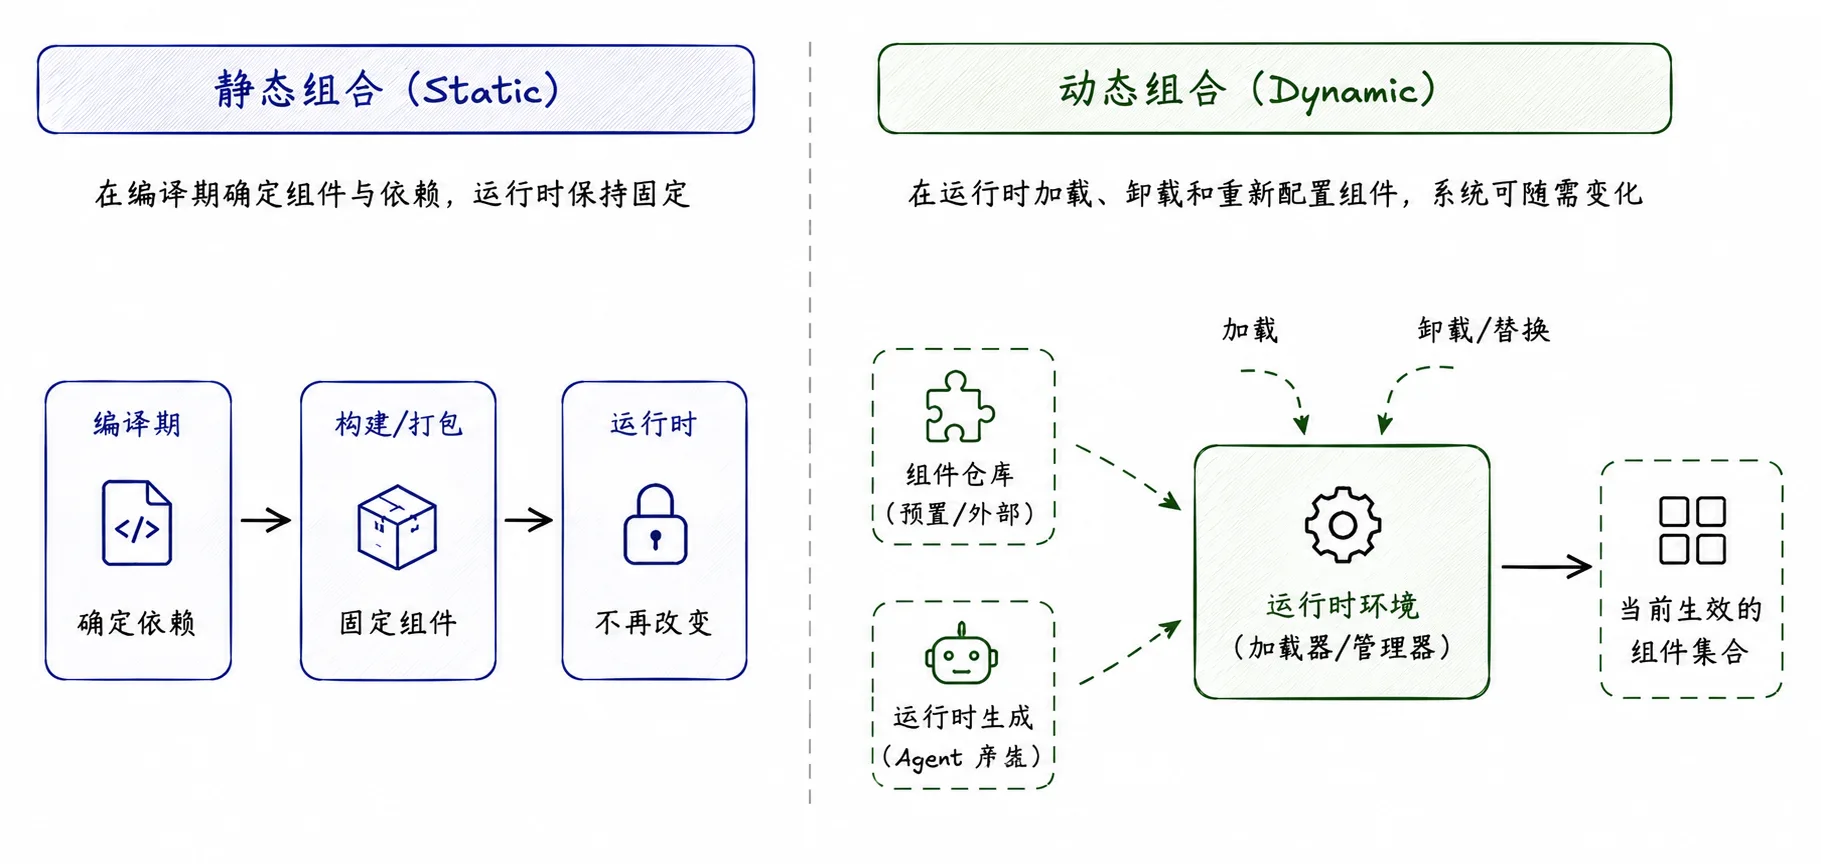
首先,我们先看传统软件的特点,基本上都属于静态组合:函数调用、模块导入以及类之间的继承关系在编译期就需要确定,在运行时保持固定,不会改变。
随着技术的发展,现代软件越来越需要动态组合的能力:在运行时实现组件的加载、卸载和重新配置。
比较有代表性的动态组合系统是插件系统和自进化 Agent Harness。但是现有的实现方式往往基于粗粒度机制,比如直接重启,这样会丢失运行时状态。
动态组合越来越重要,但理论基础仍显不足,我觉得这也是为什么 paper 里面这么多数学公式的原因吧。
为了精准描述动态组合的需求,论文中在时间和空间维度分别提出:
- 时间可组合性(Temporal composability):当卸载一个组件时,这个组件对环境产生的影响必须被安全、完整地撤销。也就是这个组件修改了环境中的什么,卸载时怎样撤销?
- 空间可组合性(Spatial composability):组件必须声明自己所需的依赖,并且当依赖发生变化时,当前组件能够作出响应。也就是当组件所需的依赖全部可用时,当前组件要自动 load。
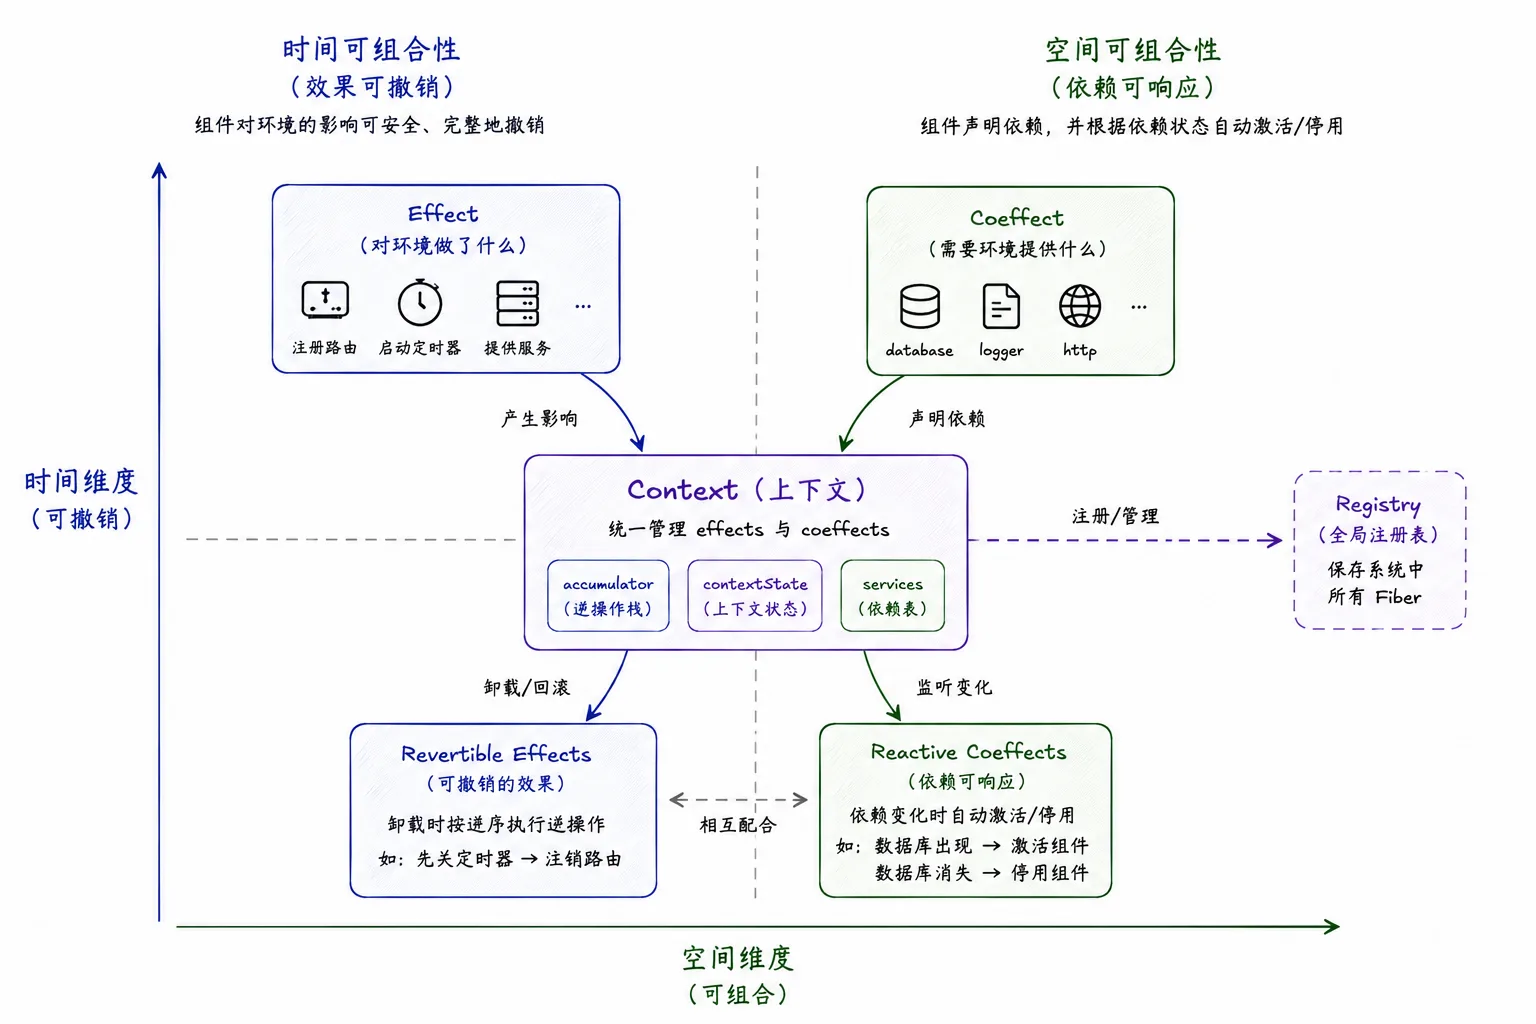
一个系统同时满足这两点,才能安全地动态装卸组件。
基于上面的描述,给一个问题:
一个插件注册了 HTTP 路由,并依赖数据库服务。数据库被撤走时,它应该停止工作;插件被卸载时,HTTP 路由也应该消失。
哪一个部分属于时间可组合性,哪一部分属于空间可组合性?
现有技术的不足
上文提到的插件系统和自进化 Agent Harness,算是现有需要动态组合能力的代表性系统,但还是存在缺陷。
比如,论文中对插件系统举了一个例子:大家所熟知的 VSCode。
时间维度的限制:VSCode 的所有插件运行在一个共享进程中。尽管插件能动态安装,但是并没有提供在运行时卸载某个插件的机制。如果要卸载一个插件,就需要重启整个进程,将影响所有已经加载的插件。在 VSCode 安装量前 100 的插件中,有 87 个插件在移除前需要重启进程。
空间维度的限制:VSCode 中提供了方法声明插件之间的依赖关系,但是使用量却非常少。在安装量前 100 的插件中,仅有 7 个插件使用该功能。根本原因在于 VSCode 没有为插件之间的协作提供安全、结构化的方式。
再说自进化 Agent Harness,现有的 Agent Harness 已经可以组合各种工具、运行环境、沙箱以及权限等等模块。但未来的智能体框架(这里指自进化 Agent Harness),需要在持续提供服务的同时,生成并且部署对自身组件的修改。
在运行时不停地修改,而且没有人工监督,动态组合就变得非常重要:
- 如果没有时间可组合性,每次自我修改都要强制重启,丢失所有进程累积的状态;
- 如果没有空间可组合性,每个模块必须自行检测并适应其所依赖模块状态的改变。
当然,现有系统不是完全没有解决办法,只是这些办法的粒度比较粗。
在时间维度上,操作系统以“进程”为单位提供隔离和回收:一个组件出了问题,就重启整个进程。在空间维度上,容器编排系统以“服务”为单位管理依赖:把不同组件拆成独立服务,再通过网络进行调用。
这种方式确实能解决一部分问题,但代价也很明显。为了替换一个组件而重启整个进程,会丢失缓存、连接和正在进行的计算;为了管理组件之间的依赖而把它们拆成独立服务,又会引入额外的网络和部署成本。
Cordis 想解决的,就是这种粒度不匹配的问题:在组件这一层,同时管理它产生的影响和它所依赖的能力。
effect & revertible effects
先回顾一下时间可组合性:
组件留下的修改需要支持撤销。
先提出一个概念 effect:论文里把它形容为「程序对环境做了什么」。
比如以下代码表示在路由表中添加了一个路由:
router.add("/users", handler)这个操作修改了环境,导致路由表多了一项,因此它是一个 effect。
时间可组合性要求组件留下的修改需要支持撤销,所以论文提出了 Revertible Effects 机制来满足时间可组合性。
它是怎么做的呢?直接看例子代码:
function heartbeat(ctx: Context) {
  ctx.effect(() => {
    const timer = setInterval(() => console.log('tick'), 200) // 这里启动了定时器,是一个 effect,对环境产生影响
    return () => { // 这里返回一个闭包,内容是关闭定时器,在卸载组件时会被调用
      clearInterval(timer)
      console.log('heartbeat cleaned up')
    }
  })
}
直接通过代码就可以看出来,在调用 ctx.effect() 时,回调返回的闭包就是这个 effect 对应的 inverse(逆操作)。Cordis 会把它记录下来,并在组件卸载时调用。这一整套让 effect 可以撤销的机制,就是 Revertible Effects。
多个 effect 怎样撤销?
假设一个插件依次添加路由、注册监听、启动定时器,对环境产生多个不同的 effect,那么在撤销的时候必须反向执行对应的 inverse,也就是先关闭定时器、再注销监听器,最后删除路由。
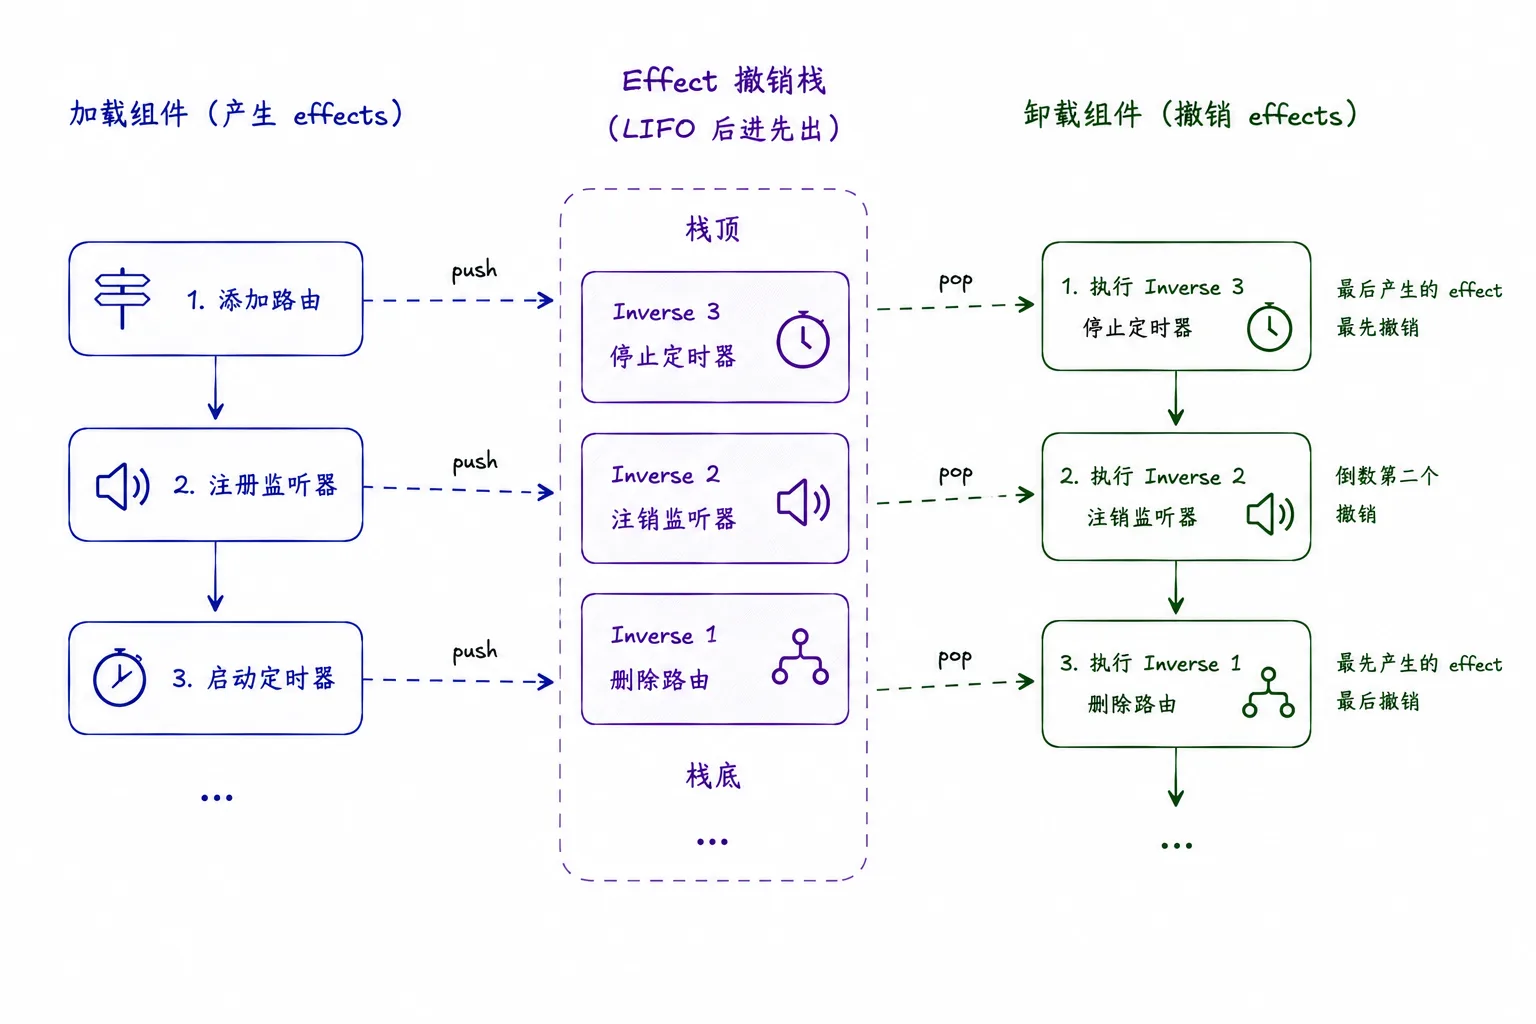
和调用栈一样,LIFO,后进先出。
effect independence
如果系统中多个插件修改了同一个公共变量,是否可以随意撤销一个 effect?
这就引出了论文中另一个关键概念:effect independence。
这个概念用于规定什么条件下可以随意撤销,什么条件下不可以随意撤销。
它的核心条件是:两个组件的 effect 及其逆操作互不干扰,也就是彼此独立。直观上,可以用“交换顺序后结果是否相同”来判断。
独立的例子:
# 例子 1:无论先撤销谁,都不会破坏另一个
组件 A:注册路由 /users
组件 B:启动定时器

# 例子 2:通常也可以随意撤销,因为不管先撤销谁,另一个的贡献依然存在
组件 A:counter += 1
组件 B:counter += 1
逆操作都为:counter -= 1
不独立的例子:
初始:theme = "light"

组件 A:theme = "dark" 逆操作:theme = "light"
组件 B:theme = "blue" 逆操作:theme = "dark"
如果遵守 LIFO 规则,先卸载 B,再卸载 A,完全正确。
如果先卸载 A,theme 会被设置为 light,直接把 B 的贡献抹除了。
这种不独立的 effect 就不能随意撤销,需要借助马上要引出的 coeffect 声明组件之间的依赖,让撤销遵循依赖顺序。
这里可能会疑惑,既然前面多个 effect 要求遵守 LIFO 规则,为啥这里不直接 LIFO,不就不存在这个问题了?
其实之前的 LIFO 是同一个组件内部的
effects使用一个撤销栈,必须后进先出。这里说的是不同组件之间的影响,而不同组件之间没有一个全局撤销栈。
coeffect & reactive coeffects
先回顾一下空间可组合性:
组件能够明确声明依赖,并根据依赖的状态实时改变自身状态。
先解释一下 coeffect,论文形容它为「程序需要环境提供什么」。
比如以下代码表达的是,当前程序/组件要运行,环境应该向它提供数据库服务。
const database = context.get("database")传统的静态组合通常在编译期处理依赖。Cordis 把它变成了运行时也可以动态组合,也就是环境每次发生变化,都重新检查组件的需求是否得到满足。
数据库出现   → 激活组件
数据库消失   → 停用组件
数据库没变化 → 不做处理
这就是论文提出的 Reactive coeffects:响应式处理依赖关系,满足前面提到的空间可组合性。
它的实现思路其实很简单,比如一个组件通过这样的方式声明所需的依赖:
d = { database, logger }只有当环境 Context 中的 database 和 logger 全部存在时,当前组件才可以运行。
运行过程中,如果发现 database 不存在了,当前组件就必须停用。
Isolation
论文中提出了隔离的概念,解决的是“同一种依赖,在不同上下文中应该指向哪个实例”。
比如在多 Agent 执行任务时,Agent A 需要的 database 是数据库 A,Agent B 需要的 database 是数据库 B。在声明依赖时,不需要特意声明自己所依赖的数据库是 A 还是 B,而是直接声明 database 即可。当它们处于不同的 context 下时,会解析到不同的数据库。
Interception
论文还提出了拦截的概念,类似于 Java Spring 中遍地都是的 AOP(面向切面编程)。
简单地说,当插件依赖的是写入工具时,你可以在工具执行前后添加新的逻辑,比如权限、日志等功能。
effect & coeffect
前面分别阐述了 effect 和 coeffect,但在实际运行过程中,它们是互相配合的。
举个例子:向 context 提供 database。
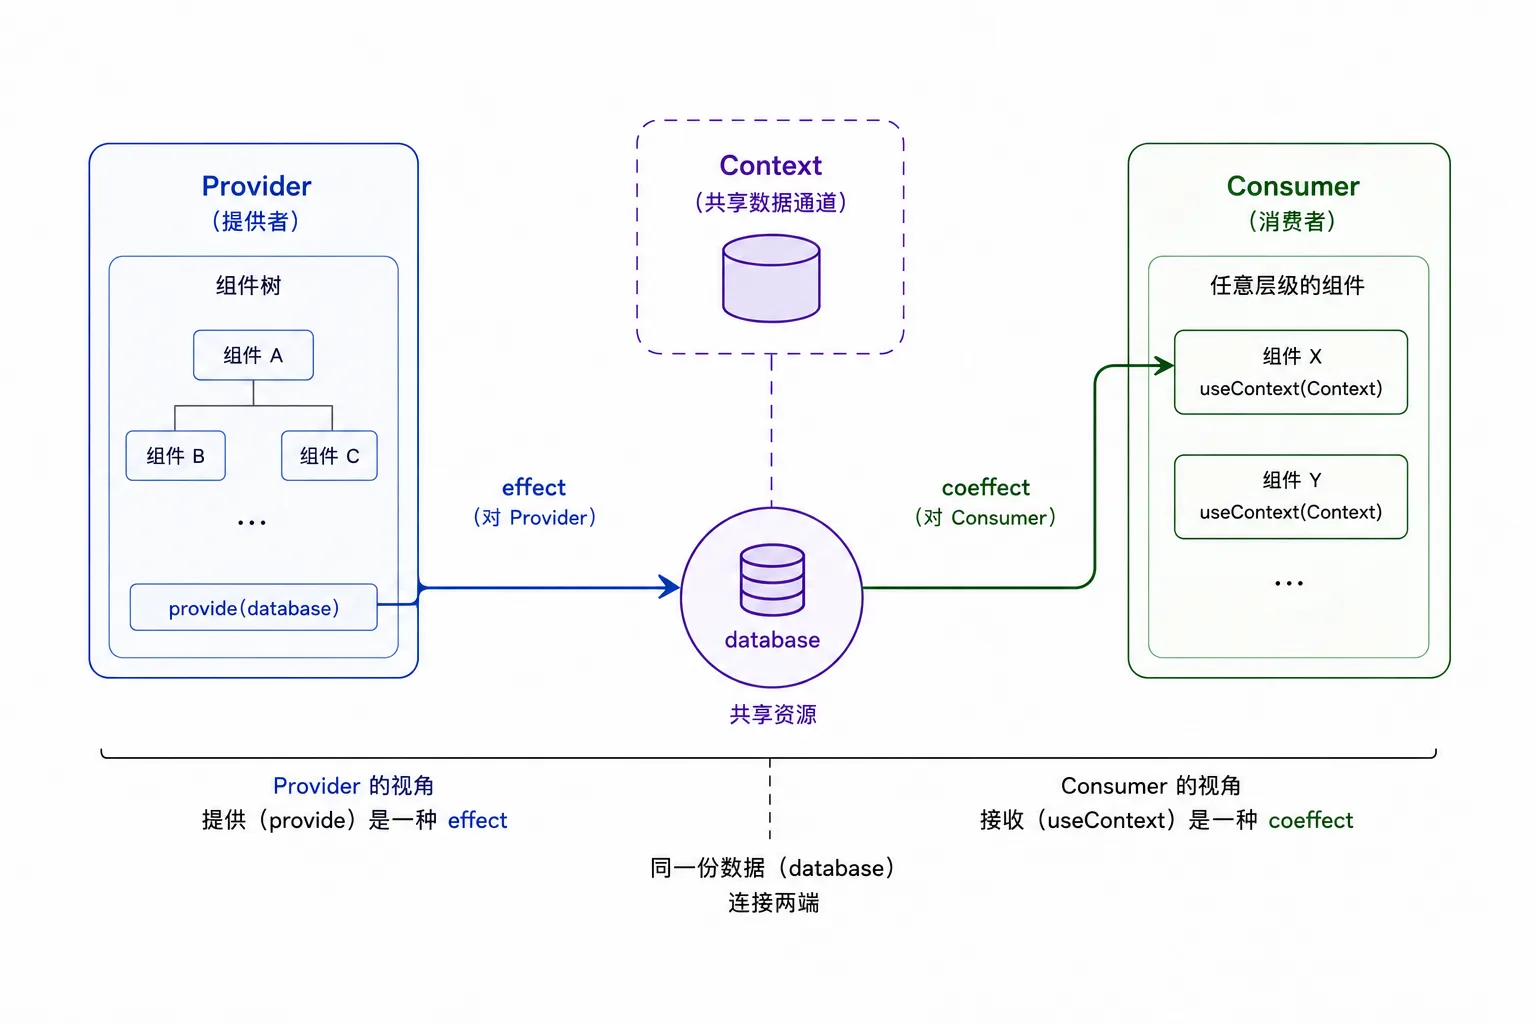
对于提供者,也就是执行这个提供逻辑的组件来说,这是一个 effect。它修改了 context,添加了数据库服务,对环境产生了影响。
对于消费者,也就是依赖 database 的组件来说,这是一个 coeffect。它依赖的数据库出现了,如果它仅依赖数据库,那么消费者组件现在就可以运行了。
The Context Paradigm
到目前为止,有两套机制:
- Effect context:保存组件产生的 effects 及其逆操作;
- Coeffect context:保存系统提供的依赖,并检测依赖满足性。
论文提出了 The Context Paradigm(上下文范式),将两种 context 统一到一个 context 中。
它的结构可以抽象为:
Context {
  contextState,  // Context 状态
  accumulator,   // 本层 effects 的撤销操作
  services       // coeffect 依赖表
}
这样设计可以让一个 context 同时回答:
- 这个组件能访问哪些环境能力?
- 它依赖哪些服务?
- 它对环境做过哪些修改?
- 卸载时如何撤销这些修改?
所以,要获得 Cordis 的追踪和恢复能力,组件与环境的交互就需要经过它。
Context 是递归的
在具体实现中,不可能由一个 Context 实例保存所有的 effects 和 coeffects,所以 Context 整体是一个可递归的层级结构。
每个组件可以获得一个 子 Context,子组件又可以继续创建自己的 子 Context。
类似于如下结构:
根 context
├── 数据库组件的 context
├── 路由组件的 context
│   ├── 用户插件的 context
│   └── 管理插件的 context
└── 日志组件的 context
每一层只累积属于自己的 effects。于是:
- 加载组件:在其 context 中执行 effects;
- 卸载组件:执行该 context 中的 accumulator;
- 卸载父组件:可以连同其子树一起回收。
Components & Fibers & Registry
论文里将 Component 定义为三元组:
Component = (d, p, e)

d:dependencies,组件需要什么
p:provisions,组件可能提供什么
e:effects,组件激活后做什么,以及怎样撤销
例如一个用户 API 组件:
d = { database, logger }
p = { userApi }
e = {
  提供 userApi
  注册 /users 路由
  启动后台任务
  并为上述操作生成 inverses
}
Component 只是定义;当它被装入系统时,会产生一个 Fiber。
所以它们之间的关系,可以类比为类和实例。Java 里面常见的 new 一个对象,这里的对象就是 Fiber。
所以 Fiber 就是 Component 的实例。同一个 Component 可以产生多个 Fiber,每个 Fiber 都有独立的生命周期和 context。
Fiber {
    d: Coeffect specification; // 当前组件需要从环境中读取的依赖
    p: Provision;              // 当前组件可能向环境提供的能力
    e: Effect function;        // 组件激活时执行的副作用,以及对应的撤销操作
    π: Parent fiber;           // 创建当前 Fiber 的父 Fiber;没有父级时为 root
    σ: Coeffect table;         // 当前 Fiber 激活后实际提供的能力及其值
    τ: Retirement flag;        // 是否已收到退役请求;收到后不应再次激活
    θ: Lifecycle state;        // 当前生命周期状态,如 Inactive、Active 等
    g: Accumulator;            // 当 θ = Active 时,累积的撤销操作,卸载时用于恢复 effects
    ω: Committed view;         // 当 θ = Active 时,激活时每项依赖实际绑定的 Provider Fiber
}
这些 Fiber 需要一个地方保存,这个时候就出现了 Registry。
Registry 在整个运行系统中只有一个,保存了系统中的所有 Fiber。
Registry {
  fiberA → DatabaseComponent 的实例
  fiberB → LoggerComponent 的实例
  fiberC → UserApiComponent 的实例
}
暂时不考虑 isolation 等机制时,所有 Active Fiber 的 coeffect table 合并起来,构成系统当前的 coeffect context:
fiberA 提供 { database }
fiberB 提供 { logger }
fiberC 提供 { userApi }

全局可见 context
= { database, logger, userApi }
Target View & Committed view
系统运行过程中,会不断为 Fiber 计算 target view,类似于如下结构:
target = {
  database → fiberA,
  logger   → fiberB
}
如果当前 Fiber 被要求退出,或者任意依赖不存在,当前的 Fiber 就需要卸载。
如果没有被要求退出,依赖也都满足,而且还处于未激活状态,就需要执行激活逻辑。激活时,会把当时的 target view 保存为 committed view。
在之后的运行过程中,系统会不断比较 target view 和 committed view。
对比的目的是触发重载。比如在某次计算 target view 时,发现 database 的 provider 变成了 fiberC,这样就和 committed view 不一样了,需要将当前 Fiber 先卸载,再按照新的依赖重新激活。
生命周期
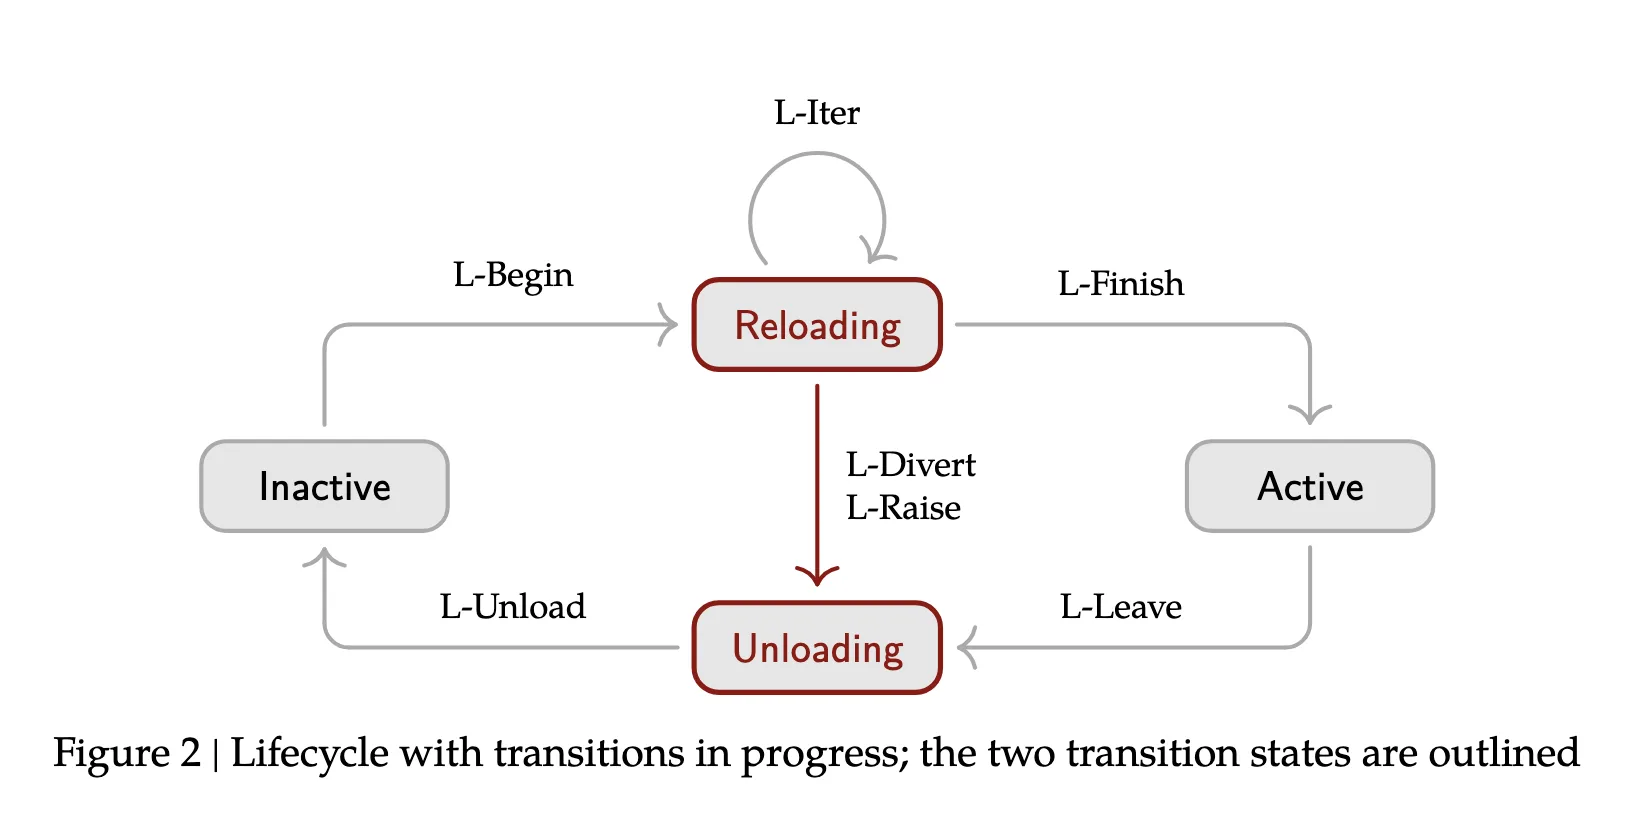
论文中的 Figure 2 将生命周期分为 Inactive、Reloading、Active 和 Unloading 四种状态,其中 Reloading 与 Unloading 表示非原子的过渡过程。
- Fiber 在依赖满足后进入 Reloading,分步执行 effects 并积累 inverse,加载完成后进入 Active;
- 当依赖变化、Provider 被替换或收到退役请求时,Fiber 进入 Unloading,在等待消费者退出后执行 accumulator(逆操作),并回到 Inactive;
- 加载过程中的中断与失败也统一进入 Unloading,从而保证已经产生的 effects 总能得到恢复。
小结
以上基本就是我理解的 Cordis 核心概念。论文剩余部分还在探讨具体实现案例、系统边界、为什么选择 TypeScript 实现以及相关工作,我觉得这些都不属于本文要记录的核心概念。等深入到源码层面学习时,再看这些内容可能会理解得更深;这篇文章先只记录核心概念,就不过多展开了。
在书写过程中,我其实发现实际的 Cordis 源码细节要比论文中多得多,比如 Context 的定义有很多成员变量,不是我简单写的只有三个。
所以,我之后也会继续基于 DeepSeek Harness 源码学习,比如里面的 profile、cordis.yml 等等概念是如何运行的。我相信有了这篇文章里的基础概念作为知识储备,之后会学得越来越容易。
我也会随时分享,欢迎关注,谢谢大家。